图像篡改定位中的 F1 与 Macro-F1:指标混用为何会造成性能高估
文章目录
起因
在图像篡改定位(Image Manipulation Localization,IML)任务中,通常使用像素级(pixel-level)F1 来评估模型对篡改区域的定位能力。但同样写作“F1”,不同实现可能计算的是不同指标。
HIFI_IFDL 项目中的一个 issue 讨论了 F1 的选择问题,相关代码截图如下:
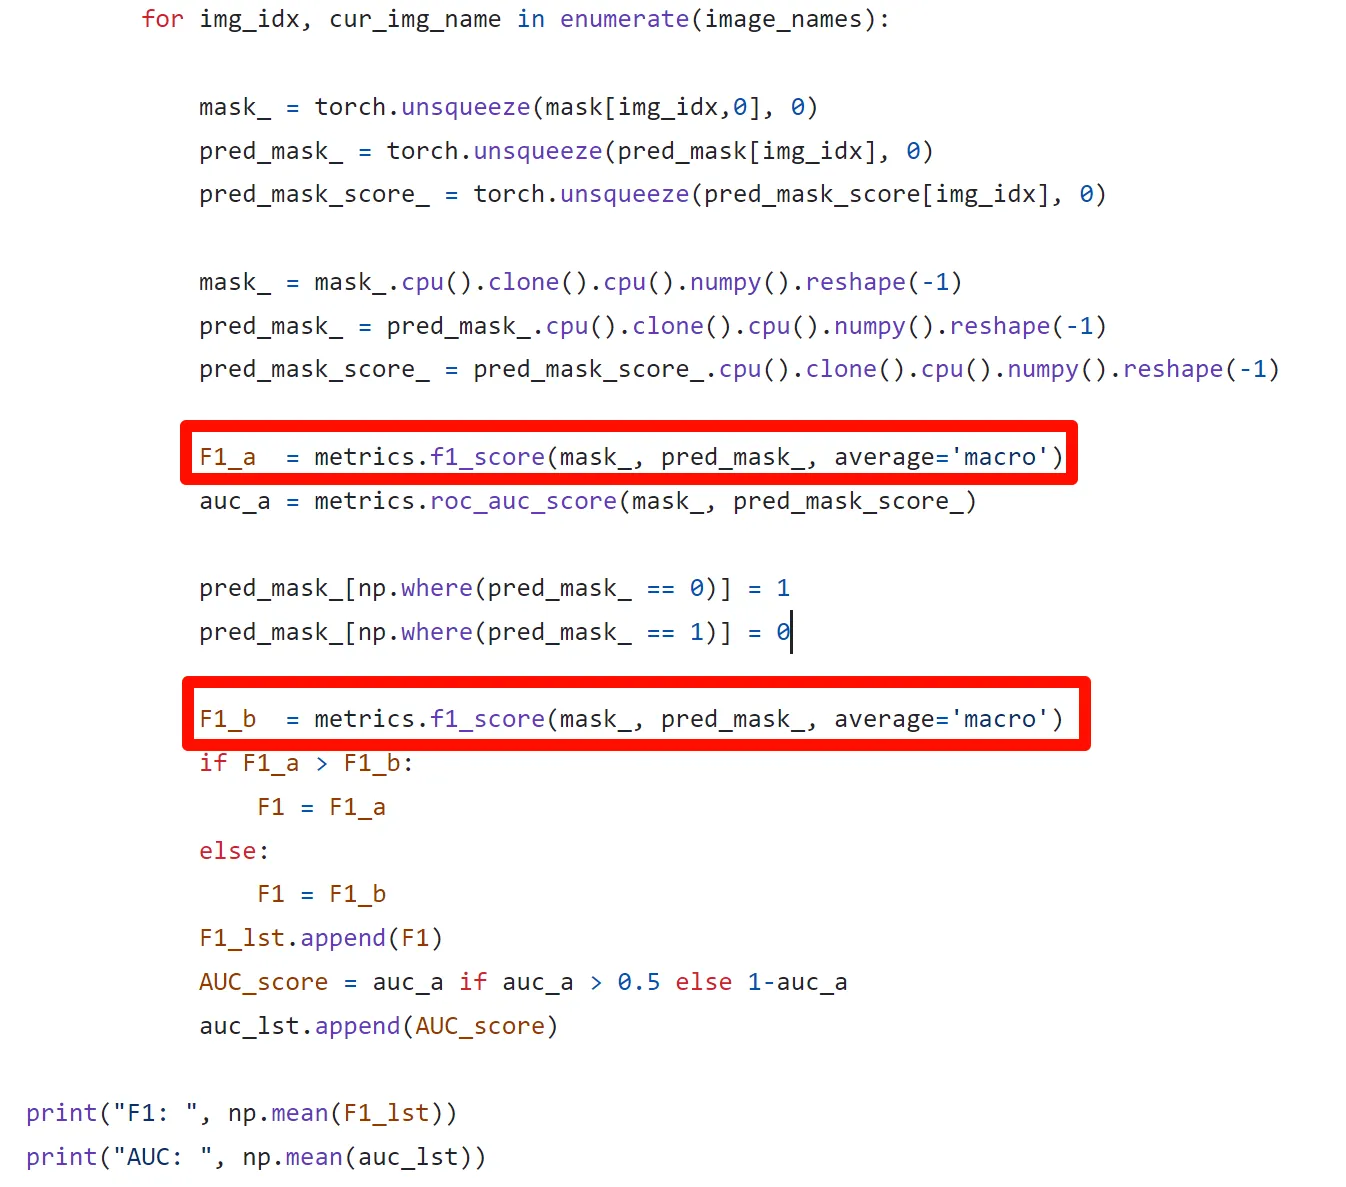
提出者询问,使用 average='macro' 是否会比使用 average='binary' 得到更高的分数:
When you use “average = ‘macro’”, will the F1 score be inflated higher than normal (average = ‘binary’)?
这个问题需要区分两件事:Macro-F1 在什么条件下更高,以及更高的数值是否意味着篡改定位能力更强。 下文固定真实标签和预测结果,只比较类别平均方式带来的差异。
需要注意,截图中还包含对预测掩码进行修改后重新计分、再取较大 F1 的逻辑,这属于另一项评估设置。截图中的两次原地赋值也不等价于正确的二值掩码取反:先把 0 改成 1,再把 1 改成 0,会将二值掩码全部变成 0。因此,不能仅凭这段代码把实验分数的所有变化都归因于 average='macro'。
数学分析
前景 F1
本文将篡改像素定义为正类(前景,标签为 1),真实背景像素定义为负类(背景,标签为 0):
- :正确预测为篡改的篡改像素数。
- :被误判为篡改的背景像素数。
- :被漏判为背景的篡改像素数。
- :正确预测为背景的背景像素数。
前景 F1 是前景 precision 与 recall 的调和平均数。在相应分母非零时:
将它们代入 F1 公式,可以得到:
后一个计数形式在 时可直接使用,也覆盖了 但存在误报或漏报的情况。在 scikit-learn 中,以 pos_label=1 设置 average='binary',计算的就是这里的前景 F1。
前景 F1 不直接计入 ,但它并非只关注真实篡改区域内的像素:背景上的误报会通过 降低分数。
Macro-F1 Score
Macro-F1 是各类别 F1 的算术平均数。若参与计算的类别数为 ,则:
对于本文的二分类定位任务,显式将前景、背景两个类别都纳入计算,有:
其中,背景类 F1 是把背景视为目标类别计算得到的:
因此:
Macro-F1 对两个类别的 F1 各赋予一半权重,不是按照前景、背景的像素数量加权。
Macro-F1 在什么条件下高于前景 F1?
将两者相减并通分:
当存在分类错误,即 时,分母为正,因此:
| 条件 | 两种指标的关系 |
|---|---|
| Macro-F1 高于前景 F1 | |
| 两者相等 | |
| Macro-F1 低于前景 F1 |
如果预测完全正确,且真实标签中前景、背景都存在,则两种指标均为 1。如果某个类别在真实标签和预测中都不存在,该类别 F1 的计数公式会出现 ,需要单独约定处理方式。
为什么在篡改定位中经常观察到 Macro-F1 更高?
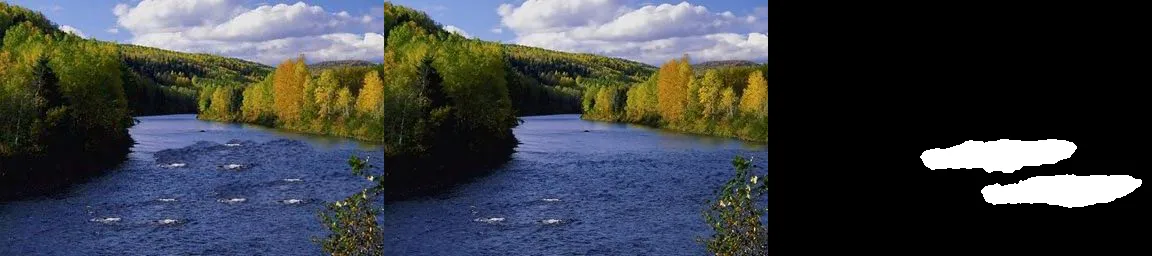
在不少篡改定位样本中,背景区域比篡改区域大。如果模型又能正确识别大部分背景,通常会出现 ,从而使 Macro-F1 高于前景 F1。
不过,背景面积更大只意味着:
这个条件本身并不能保证 ,还需要看模型的预测结果。因此,“Macro-F1 更高”是有条件的现象,不是二分类任务中的普遍规律。
一个极端例子:全部预测为背景
假设一张图像有 100 个篡改像素和 900 个背景像素,模型将所有像素都预测为背景,则:
此时:
模型完全没有找出篡改区域,但 Macro-F1 仍接近 0.5。这不是 Macro-F1 计算错误,而是它同时评价了背景和前景的分类表现。若用这个分数代替前景 F1 描述篡改定位能力,就可能造成误导。
这个例子也不意味着“预测更多背景必然提升 Macro-F1”。将误报的背景改判正确,与将正确识别的篡改像素改判为背景,对混淆矩阵的影响不同,不能混为一谈。
交互实验:同一份预测,两种分数
可以先选择“全部预测为背景”,复现上面的例子;再选择“前景较多”,观察 Macro-F1 低于前景 F1 的情况。也可以保持两类识别率不变,只调整篡改区域占比,看看 与 的大小关系如何影响结果。
启用 JavaScript 后可使用 F1 交互实验台。静态示例:全部预测为背景时,前景 F1 为 0,Macro-F1 约为 0.474;两类都存在且预测完全正确时,两者均为 1。
篡改定位任务应该使用哪个指标?
如果关注的是模型对篡改区域的定位能力,应优先报告以篡改像素为正类的前景 F1。Macro-F1 可以作为补充指标,用来展示对两个类别的综合表现,但必须明确标注,不能与其他方法的前景 F1 直接比较。
选择前景 F1 的主要理由是它与篡改区域定位这一评估目标相匹配,而不是“类别不平衡就不能用 Macro-F1”。
为了使实验结果可比较,还需要统一以下设置:
- 正类定义和类别平均方式。 明确篡改像素是否为标签 1,使用的是
average='binary'还是average='macro'。scikit-learn 默认根据真实标签和预测标签中出现的类别确定宏平均的类别集合;若要始终纳入背景、前景两个类别,应显式设置labels=[0, 1]。 - 图像之间的聚合方式。 每张图计算前景 F1 后再取平均,与汇总整个数据集的像素后计算一次前景 F1 不同。F1 是非线性指标,两者通常不相等。逐图平均也不等于
average='macro',后者指的是对类别取平均。 - 预测的二值化阈值。 固定阈值、在验证集上选定阈值和在测试集上寻找最优阈值,是不同的评估协议,不能直接比较。
- 空掩码的处理方式。 对没有篡改区域的图像,应说明是否纳入统计,以及前景 F1 未定义时采用什么约定,例如
zero_division的具体设置。 - 预测后处理与择优规则。 若允许掩码取反,或根据真实标签从多个预测结果中选择分数最高者,应明确说明;这与固定前景语义、直接评估模型输出的设置不同。
前面的大小关系推导针对同一组像素的混淆矩阵。如果实验最终报告的是逐图平均分数,应先逐图应用上述关系,再比较平均结果,不能直接用汇总混淆矩阵代替。
结论
在以篡改像素为正类的二分类定位评估中,当存在分类错误且 时,Macro-F1 高于前景 F1。背景占比较大且模型能正确识别大部分背景时,容易出现这种情况。
这种数值差异来自背景类 F1 的引入,并不代表模型对篡改区域的定位能力提升。真正的问题是指标混用:把 Macro-F1 当成前景 F1 报告,或将不同评估口径下的分数直接比较。
因此,评价篡改区域定位能力时,应明确报告前景 F1,并统一正类定义、类别平均方式、图像聚合方式、阈值、空掩码处理及后处理规则。只有评估口径一致,分数高低才有可比性。